我中心关于多组学癌症亚型分类研究取得进展 相关研究成果发表在Bioinformatics (2026)
近日,我中心在多组学融合与癌症亚型分类研究领域取得重要进展,相关成果被国际生物信息学领域顶级学术期刊《Bioinformatics》录用并在线发表。Bioinformatics由牛津大学出版社(Oxford University Press)出版,是国际计算生物学学会(ISCB)的官方期刊,是生物信息学与计算生物学领域历史悠久、具有重要国际影响力的代表性学术期刊,被中国计算机学会(CCF)推荐为A类学术期刊,主要发表生物信息学算法、计算方法及生物医学数据分析方面的高水平研究成果。
第一作者为四川大学计算机学院拔尖计划试验班大三本科生范博洋,我中心琚玮特聘副研究员与中国科学院新疆理化技术研究所尹衡闯助理研究员为共同通讯作者,中心主任吕建成教授、四川大学数学学院易思宇特聘副研究员等参与研究,合作单位包括中国科学院新疆理化技术研究所、对外经济贸易大学等。本研究针对多组学数据中各组学模态的信息量与噪声水平随癌种和患者变化的难题,提出了一种置信度引导的多组学图学习框架(CMGL)。该框架基于证据深度学习,在融合之前为每位患者的每种组学独立估计置信度并在下游保持冻结,再以置信度门控实现跨组学特征融合;同时构建跨模态一致的交集k近邻患者图,抑制结构噪声在图传播中的扩散。实验结果表明,CMGL在MLOmics的四个单癌种亚型分类任务与32类泛癌任务上均取得最优表现,其学到的表征能够恢复乳腺癌PAM50内在亚型,并可在不经微调的情况下迁移至肾透明细胞癌,实现具有显著预后差异的患者分层,为可信、可解释的多组学精准肿瘤学分析提供了新的技术路径。
论文发表:Bioinformatics(牛津大学出版社,CCF A类期刊,2026,btag763,2026年10月12日在线发表)
论文链接:https://doi.org/10.1093/bioinformatics/btag763
代码链接:https://doi.org/10.5281/zenodo.21921069
1. 引言
基于多组学谱的癌症分子分型已成为精准肿瘤学的核心环节。通过整合mRNA表达、miRNA表达、DNA甲基化与拷贝数变异(CNV)等多种组学数据,可以为患者分层与治疗选择提供依据。例如,乳腺浸润性癌(BRCA)中基于转录组定义的PAM50内在亚型,十余年来一直直接指导着临床决策。然而,各组学模态的信息量随癌种而变化:BRCA亚型主要由mRNA表达与DNA甲基化决定,而卵巢浆液性囊腺癌(OV)亚型则主要由拷贝数改变驱动;即便在同一癌种内部,批次效应与肿瘤异质性也会使不同患者的组学可靠性存在差异。已有研究表明,加入信息量不足的模态并不一定能提升分型效果,模态特异的噪声反而会阻碍一致的多组学表征学习。
多组学融合方法已从特征选择与核方法,发展到自编码器、注意力机制、胶囊网络、预训练Transformer等深度方法,其中基于患者关系图的图学习方法(如MOGONET、MOSGAT)已成为主流方向之一。然而,现有方法仍面临以下两方面局限:
模态贡献与分类目标相互耦合:现有方法通常将模态权重视为潜变量,与分类目标联合优化,所得权重反映的是分类驱动下的最优解,而非模态层面的可靠性估计。每位患者的预测可靠性因而是隐式的,信息量不足的模态会削弱融合后的表征。
患者关系图易受结构噪声干扰:不可靠的组学会在患者关系图中引入噪声边,而图结构噪声会经由图神经网络的消息传递不断扩散。从生物学角度看,这意味着真实亚型的分子特征可能被来自无信息模态的噪声所稀释。
两类局限相互交织,核心问题在于:如何在融合与图推理之前,判断每位患者的哪些组学模态是可信的,从而让可靠的模态主导后续的信息流动?
针对这一问题,我们提出置信度引导的多组学图学习框架CMGL。其核心思想是:模态可靠性应当先于融合与图推理被独立估计,且不随下游梯度更新;置信度负责调节特征层面的模态贡献,跨模态一致的近邻关系负责约束患者之间的信息传播。据我们所知,在基于图的多组学癌症分型方法中,CMGL首次在独立阶段学习患者级模态置信度,并在下游融合中保持固定。本文的主要贡献如下:
• 提出两阶段解耦的多组学图学习框架CMGL,以证据深度学习在融合前为每位患者的每种组学估计置信度,并在下游冻结使用,将可靠性估计与分类优化相分离;
• 设计置信度引导的双重门控融合与一致性交集图构建,分别从特征聚合与患者间信息传播两个层面抑制不可靠组学与结构噪声;
• 在MLOmics的4个单癌种任务与32类泛癌任务上开展了大量实验,CMGL在全部任务上取得最高的准确率与Macro-F1,四个单癌种任务平均准确率较最强基线提升4.03%;其表征可恢复BRCA的PAM50亚型,并可零微调迁移至KIRC实现预后分层。
2. 核心方法
如图1所示,CMGL采用两阶段设计,包含四个核心模块:(1) 证据驱动的组学置信度学习(阶段一):为每位患者的每种组学输出逐类证据并估计模态置信度,训练后冻结;(2) 置信度引导的跨组学融合(阶段二):以跨组学自注意力交换模态信息,再以置信度进行特征级与模态级双重门控聚合;(3) 一致性交集图构建:在各组学上分别构建k近邻患者图并取交集,仅保留跨模态一致的近邻关系;(4) 图消息传递与分类:在交集图上以两层GraphSAGE传播亚型信息,并联合标签平滑交叉熵与监督对比损失进行优化。下面依次介绍各模块的具体设计。
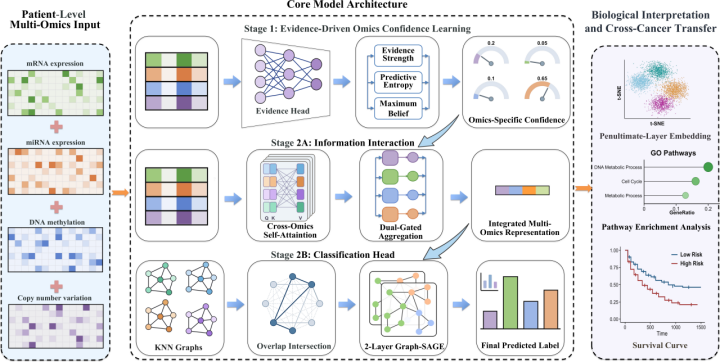
图1:CMGL框架图
2.1 证据驱动的组学置信度学习
不同组学对分类的可信程度不仅随癌种变化,也随患者变化。阶段一的目标是回答:对于每位患者,每种组学应当被信任到什么程度?对第m种组学,编码器将原始输入映射到统一的隐空间,证据头输出非负的逐类证据e,并按照证据深度学习(EDL)框架构建Dirichlet分布:
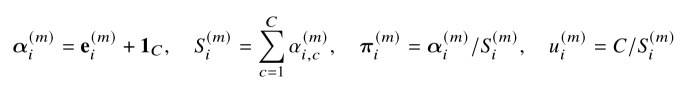
其中,α为Dirichlet参数,S为Dirichlet强度,π为预测均值,u为认知不确定性,C为类别数。与需要多次前向传播的蒙特卡洛Dropout和深度集成不同,EDL在单次前向传播中即可同时获得预测与不确定性估计。
单一的不确定性信号难以稳健刻画模态可靠性。为此,CMGL从证据中提取四种互补的质量信号:对数证据强度a(累积证据量)、认知不确定性u、归一化预测熵H(类别分布的模糊程度)以及最大预测概率π_max(对首位类别的集中程度)。逐模态评分网络Q_m将这些信号映射为分数,再经可学习温度T缩放与softmax归一化,得到模态置信度:
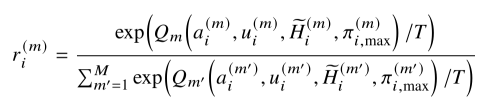
直观上,当某组学对单一类别给出集中的证据、且类别熵较低时,该组学会获得较高的置信度。阶段一的训练目标由三项构成:带退火KL正则的EDL损失、降低低置信度模态预测贡献的置信度加权分类损失,以及避免各模态权重趋于均匀的多样性约束:
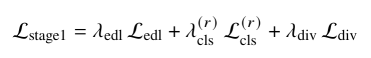
训练完成后,置信度向量r_i被冻结,作为可靠性先验供阶段二使用,不再接受下游梯度的更新。
2.2 置信度引导的跨组学融合
在置信度固定的前提下,阶段二需要融合互补的分子信号,同时保留阶段一为每位患者分配的模态可靠性。首先,各组学经独立编码器映射到共享空间,并加上可学习的模态身份嵌入以区分信息来源;随后,多头自注意力在M个模态token之间交换信息,捕捉跨组学的互补特征。在此基础上,CMGL以置信度进行双重门控聚合:逐维门控向量g调节单个特征维度,标量置信度r分配组学层面的权重,最终得到融合表征z:
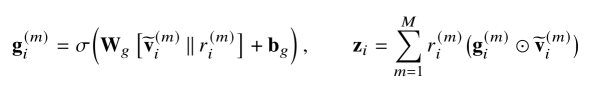
其中,σ为Sigmoid函数,‖表示向量拼接,⊙为逐元素乘积。低置信度模态在特征维度与模态层面同时受到抑制,从而避免噪声组学稀释具有亚型判别力的特征。
2.3 一致性交集图构建与图分类
获得可靠性加权的融合表征后,CMGL进一步约束患者之间的消息传递。考虑到图结构变化与结构噪声会扭曲图神经网络的聚合过程,CMGL在每种组学的标准化输入特征空间中以余弦距离分别构建k近邻图,并仅保留各模态图的交集:
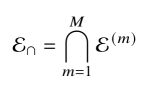
由此,只有在所有分子视角下均成立的近邻关系才会参与信息传播。构图时,边仅建立在训练节点之间或训练节点与评估节点之间,评估节点之间不建边,使每个评估样本仅从训练近邻处聚合信息;近邻数k则在每一折中通过短暂预热、依据验证集Macro-F1从{7, 11, 15, 19, 23}中自适应选取。随后,两层GraphSAGE在交集图上将每位患者的融合表征与可信近邻的亚型信息相结合,并通过残差连接保留患者自身信息:
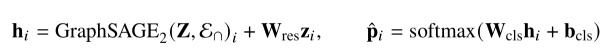
其中,h_i为倒数第二层嵌入,后续全部生物学分析均基于该嵌入完成。
2.4 训练目标
阶段二的优化目标包含两项。分类信号由带类别权重的标签平滑交叉熵提供,其中平滑系数ε=0.1,类别权重取逆频率的平方根并归一化至均值为1,以缓解类别不平衡:
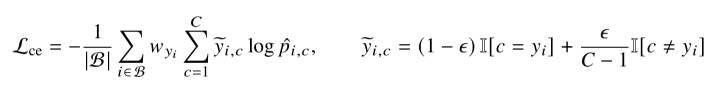
同时,在L2归一化后的嵌入上施加温度τ=0.1的监督对比损失,使同类患者的嵌入相互靠近、异类患者的嵌入相互远离:
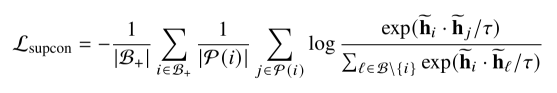
其中,P(i)为批内与锚点i同类的样本集合,B+为存在正样本的有效锚点集合。最终,阶段二损失为两项的加权和:
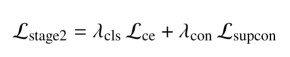
其中,λ_cls与λ_con为损失系数(默认分别取3.0与1.0)。阶段二在固定置信度下完成优化后,依据验证集Macro-F1选取最终模型,用于分类评估与后续的生物学解释。
3. 实验
3.1 主实验结果
为了验证CMGL的有效性,我们在源自TCGA的MLOmics多组学癌症基准的四个单癌种亚型分类任务—乳腺浸润性癌(BRCA)、胶质母细胞瘤(GBM)、低级别胶质瘤(LGG)与卵巢浆液性囊腺癌(OV)上,与MOGONET、MOSGAT、HTML、MOCapsNet四个代表性基线进行了对比,覆盖多图GCN融合、特异性感知图注意力、Dirichlet证据融合与胶囊网络等技术路线。所有实验采用5折分层交叉验证(训练/验证/测试比例为70%/10%/20%),报告准确率、Macro-F1、Weighted-F1、Macro-Recall、Macro-AUC与Macro-AUPRC六项指标的均值与标准差。
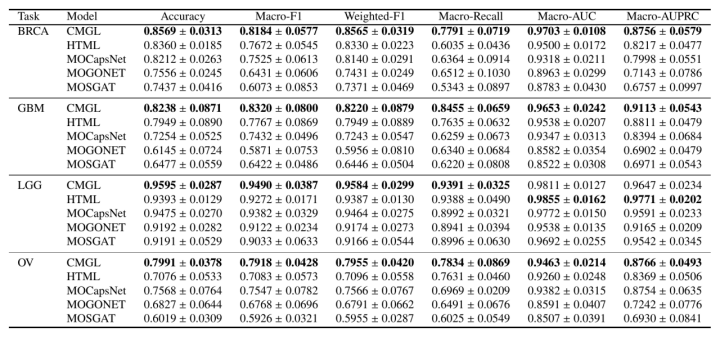
图2:四个单癌种亚型分类任务上的总体性能对比(均值±标准差,加粗为最优)
实验结果表明,CMGL在全部四个任务上均取得最高的准确率与Macro-F1:平均准确率达0.8598、平均Macro-F1达0.8478,平均准确率较次优方法HTML提升4.03%。置信度估计的优势在模态质量差异较大的任务上最为明显:在样本仅244例、单模态信号噪声较大的GBM上,CMGL的准确率与Macro-F1分别领先HTML 2.89%(校正后p=0.0294)与5.53%(校正后p=0.0091),符合“信噪比越低,显式可靠性先验越有用”的预期;而在各单一模态即可较好区分亚型的LGG上,领先幅度相对较小。
3.2 泛癌与小样本泛化
为进一步考察CMGL在更复杂场景与有限监督下的表现,我们在包含8314例样本的32类泛癌任务上进行评估;同时在每一折内将训练集分别下采样至30%与50%,以完整训练集作为参照,检验小样本条件下的泛化能力。
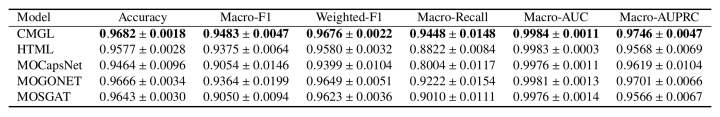
图3:32类泛癌任务上的性能对比(均值±标准差)
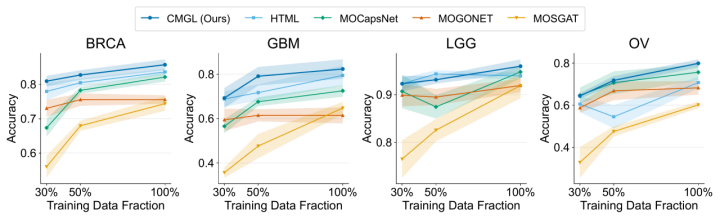
图4:四个单癌种任务上的小样本泛化曲线
实验结果表明:在32类泛癌任务上,CMGL在全部六项指标上均取得最优(准确率0.9682、Macro-F1 0.9483、Macro-Recall 0.9448),其Macro-F1显著优于MOGONET(校正后p=0.0002);由于泛癌分类本身已具备较强的单模态判别信号,领先幅度小于单癌种任务。小样本设置下,CMGL在四个任务上整体表现最强,且训练集越小,在BRCA与GBM上的优势越明显,表明冻结的置信度先验在标签稀缺时依然有效。
3.3 消融实验
为验证各模块设计的合理性,我们在相同评估协议下依次移除不确定性感知学习、跨组学注意力与两阶段解耦三个核心组件,比较各变体与完整模型在四个单癌种任务上的性能差异。
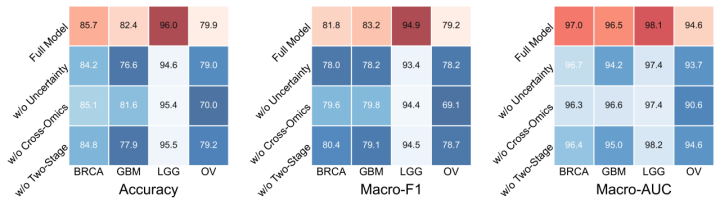
图5:核心组件消融实验(准确率、Macro-F1与Macro-AUC)
实验结果表明:移除任一组件均会导致至少一项指标下降。其中跨组学注意力影响最大,移除后平均准确率下降3.0%、Macro-F1下降4.1%,在各模态信号强度最不均衡的OV上准确率下降多达9.9%;移除不确定性感知学习使平均准确率下降2.4%,在信噪比最低的GBM上下降5.8%,说明显式的置信度估计在信号有限时尤为关键;两阶段解耦的平均影响较小(−1.6%),但在GBM上仍达−4.5%。
3.4 超参数敏感性分析
我们在BRCA上考察了CMGL对损失权重的敏感性:阶段一在λ_edl与EDL退火步长上、阶段二在λ_cls与λ_con上各构建3×3网格,共计18组配置。
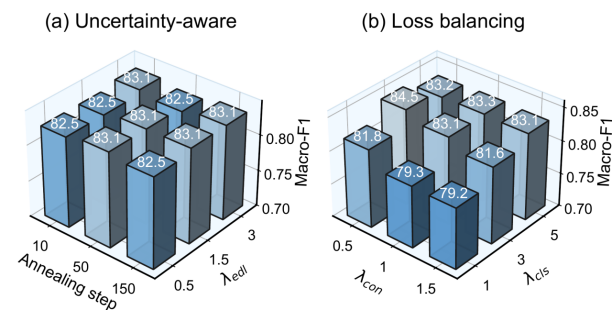
图6:BRCA上阶段一与阶段二损失权重的超参数敏感性
实验结果表明,在全部18组配置下Macro-F1的波动均小于±0.025,形成平坦的性能平台,说明CMGL在所考察范围内对损失权重具有良好的鲁棒性;近邻数k是唯一表现出一定折间敏感性的超参数,因此CMGL采用基于验证集的自适应k选择策略。
3.5 BRCA亚型的生物学可解释性
为检验模型表征是否同样捕获了已知的分子结构,我们以验证集Macro-F1最优的BRCA模型对全部671例样本进行冻结推理,基于倒数第二层嵌入与预测类别,按效应量为每个类别筛选前200个mRNA标志基因,并开展GO生物过程与KEGG通路富集分析。
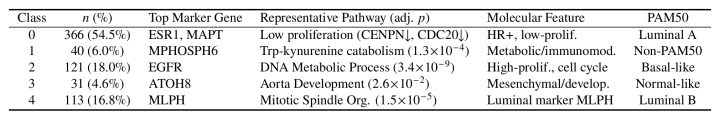
图7:五个预测BRCA亚型的样本数、标志基因、代表性富集通路及PAM50对应关系
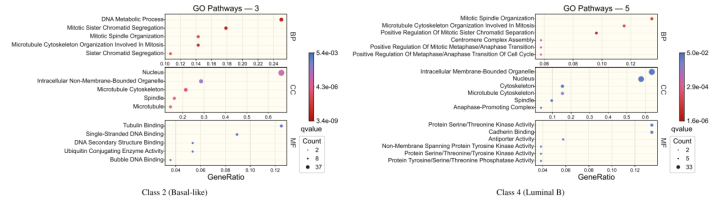
图8:增殖相关程度最高的两个BRCA类别的GO富集结果(Class 2:Basal-like;Class 4:Luminal B)
实验结果表明,预测类别的轮廓系数达0.867,类别间分离清晰,且五个预测类别的分子特征与PAM50内在亚型高度对应:Class 0(54.5%)以ESR1、MAPT为标志基因、有丝分裂标志物下调,呈现低增殖、激素受体阳性特征,对应Luminal A;Class 2(18.0%)以EGFR为标志基因,富集于DNA代谢与细胞周期,对应高增殖的Basal-like;Class 4(16.8%)以已知的Luminal B标志物MLPH为首位标志基因;Class 3(4.6%)呈现间充质/发育程序特征,推测对应Normal-like。值得注意的是,Class 1(6.0%)显著富集于色氨酸–犬尿氨酸分解代谢(校正p=1.3×10⁻⁴)与谷胱甘肽代谢,而犬尿氨酸通路是肿瘤微环境免疫抑制的关键调控机制,提示该类别可能代表一种代谢活跃的免疫调节表型。模型在没有任何生物学监督的情况下识别出这一精细特征,说明过滤噪声组学有助于在表征中保留更细粒度的分子信号。
3.6 跨癌种迁移与预后分层
为检验CMGL的表征能否迁移到其他癌种,我们将在BRCA上训练的模型直接应用于肾透明细胞癌(KIRC)队列(n=314),不进行任何目标域微调,仅通过单次前向传播提取64维嵌入,随后进行KMeans无监督聚类,并结合生存分析与通路富集,考察从乳腺癌中学到的增殖–分化轴能否对肾癌预后进行分层。
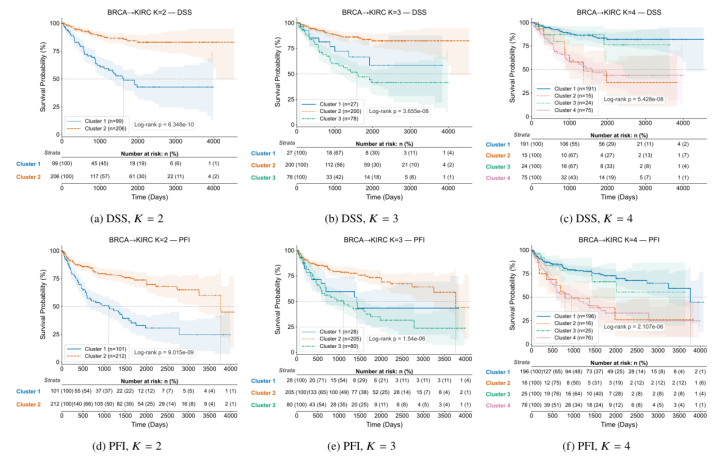
图9:KIRC在BRCA迁移表征下的Kaplan-Meier生存曲线(上:疾病特异性生存DSS;下:无进展间期PFI)
实验结果表明:综合轮廓系数与log-rank检验选定K=3(轮廓系数0.585),三个簇分别包含28、206与80例样本。在DSS终点上,总体log-rank p=3.66×10⁻⁸,高风险簇3相对低风险簇2的风险比为3.99(95% CI 2.39–6.65),5年DSS率分别为47.0%与83.8%,相差36.8个百分点;在PFI终点上,簇3的中位PFI仅为1111天,而簇2为3766天。通路富集显示,高风险簇3富集于细胞周期与有丝分裂(如p53信号通路、有丝分裂纺锤体),其标志基因CDK1、BIRC5、NDC80等均为已报道的ccRCC不良预后指标;中风险簇1呈现细胞外基质重塑特征;低风险簇2则富集于上皮极性与脂质/线粒体代谢(PPARG、PPARGC1A等),与TCGA ccRCC多组学研究中的低风险特征一致。上述增殖轴与上皮特征在K=2、3、4下保持稳定,并与ccA/ccB分型框架相对应,表明CMGL在训练中未使用任何生存信息的情况下,从分类嵌入中恢复出了可跨癌种迁移的预后轴。
4. 结论
本文提出CMGL,一个置信度引导的多组学图学习框架,将多组学癌症分型从“模态贡献与分类目标联合学习”的范式,推进到“先独立估计可靠性、再进行融合与图推理”的两阶段范式。通过证据深度学习估计患者级模态置信度、以置信度双重门控融合跨组学特征、并借助跨模态一致的交集图约束患者间信息传播,CMGL在单癌种与泛癌任务上均取得最优的分类性能,其表征能够恢复BRCA的PAM50亚型、识别代谢型亚群,并零微调迁移至KIRC实现显著的预后分层,兼顾了预测性能与生物学可解释性。CMGL仍存在一些局限:当前的模态子集实验评估的是队列层面的视图可用性,针对单个患者缺失模态的推理仍有待完善;患者图在训练前构建,尚不能随训练自适应调整。未来,我们将探索患者级缺失模态处理、训练中自适应的图构建以及跨多组学层次的联合解释,推动方法在临床场景中的落地应用。
作者简介:
范博洋,四川大学计算机学院计算机科学与技术专业(拔尖计划)大三本科生,曾担任大一、大二拔尖班班长,并作为负责人主持校级大学生创新创业训练计划项目。研究方向为生物信息学、图学习与可信人工智能。
琚玮,四川大学人工智能学院特聘副研究员,入选国家博新计划(国资计划A档),天府峨眉计划青年人才(四川省“千人计划”),2025-2026年度斯坦福大学年度全球前2%顶尖科学家,中国计算机学会人工智能与模式识别专委会委员,中国中文信息学会大模型与生成专业委员会委员。研究方向为图机器学习、生物信息学、大语言模型、推荐系统。主持国家自然科学基金(面上+青年)、国家科技重大专项子课题、四川省自然科学基金青年基金B类、中国博士后科学基金面上项目等多项国家级和省部级课题。目前已在国际顶级学术期刊和会议上发表论文100余篇(Nature子刊1篇,CCF-A/一区论文80余篇),研究成果发表在Nature Machine Intelligence、TPAMI、TKDE、TOIS、TMM、AIJ、ICLR、ICML、NeurIPS、CVPR、ACL、KDD、WWW、AAAI等国际顶级期刊和会议上,累积被引5000余次,其中多篇会议论文入选最佳论文/口头报告(ICLR 2026 Oral Paper, Top 1%、NeurIPS 2026 Spotlight, Top 1%、ICDM 2022最佳论文提名奖、ISNN 2026最佳学生论文奖),并荣获2023年度ACM SIGCSE中国“优博奖”。受邀担任国际顶级期刊IEEE TCSVT、Pattern Recognition、Expert Systems with Applications副主编,Information Fusion、Neurocomputing、Applied Soft Computing、Frontiers in Big Data编委, ICLR、ICML、ACL、KDD、AAAI、ACMMM 等国际顶级会议领域主席。