我中心关于图噪声学习研究取得进展,相关研究成果发表在Artificial Intelligence (AIJ 2026)
近日,我中心在图噪声学习研究领域取得重要进展,相关成果被国际人工智能领域顶级学术期刊《Artificial Intelligence》(简称AIJ)录用。AIJ由Elsevier出版社出版,是人工智能领域历史悠久、具有重要国际影响力的权威学术期刊,被中国计算机学会(CCF)推荐为A类学术期刊,主要发表人工智能基础理论、关键方法及应用创新方面的高水平研究成果。据调研,该成果为四川大学首篇发表于AIJ的研究论文,标志着学校在人工智能领域的研究取得新的突破。
第一作者为四川大学数学学院特聘副研究员易思宇,我中心琚玮副研究员为通讯作者,中心主任吕建成教授等参与研究,合作团队包括多所国内外高校。本研究针对图神经网络中标签噪声与标注稀缺并存的难题,提出了一种证据引导的多专家图神经网络学习框架(EvGNN)。该框架基于主观逻辑与Dempster-Shafer证据理论量化不同专家的预测不确定性,并设计多专家可信融合机制,有效缓解专家间的决策冲突。同时,结合一致性学习与伪标签策略,充分利用无标注节点信息,增强稀疏标签条件下的模型学习能力。实验结果表明,EvGNN在多个真实图数据集上表现出良好的噪声鲁棒性与分类性能,为复杂噪声环境下的可信图学习提供了新的技术路径。
论文录用:Artificial Intelligence(AIJ,CCF A类期刊,Vol. 360, 104608, 2026)
论文链接:https://doi.org/10.1016/j.artint.2026.104608
代码链接:https://github.com/wayc04/EvGNN
1. 引言
图神经网络通过消息传递机制聚合邻居信息,能够学习富有表达能力的节点表示,已被广泛应用于社交网络、引用网络、分子图、知识图谱等场景。然而,这一成功高度依赖于可靠的监督信号。一方面,众包标注者大多并非领域专家,其主观判断不可避免引入噪声标签,而已有研究表明噪声标签会严重削弱深度模型的鲁棒性;另一方面,在生物医药等高精度领域,标注一个分子或蛋白需要领域专家投入大量时间与成本,导致标签极度稀缺。
在视觉等常规数据领域,抗噪学习已形成样本选择、损失修正、标签修正三类主要范式,但面向图数据的相关研究仍有待深入。现有方法仍面临以下两方面局限:
预测可靠性刻画不足:传统神经网络倾向于过自信,噪声标签会进一步诱导模型以高置信度输出错误预测,这对疾病诊断、药物推荐等高可靠性要求的应用构成严重挑战。我们在 Pubmed 上的动机实验表明,随着噪声率升高或标签率降低,普通 GCN 的预测置信度与经验准确率之间的差距不断扩大,期望校准误差显著上升,过自信问题在噪声与稀疏共存时尤为突出。
无标注节点利用不充分:消息传递机制虽然能够隐式利用无标注节点的特征,但其蕴含的属性与结构信息本可作为正则信号指导学习,潜在价值远未被充分挖掘。在监督信号极其有限时,仅依靠少量标签难以获得充分学习。
两类局限相互交织,核心矛盾在于:如何在噪声且稀疏的监督下,既能量化预测的可靠程度,又能从无标注节点中挖掘有效的监督信号?
针对这一问题,我们提出证据引导的多专家框架 EvGNN。其核心思想是:用不确定性量化刻画预测可靠性,用多专家的互补意见降低被噪声标签共同误导的风险,再通过冲突感知的融合得到更可靠的决策,并以一致性学习与伪标签从无标注节点中提取辅助监督。本文的主要贡献如下:
• 探索了图神经网络在噪声且稀疏标签下鲁棒训练这一尚未充分研究的问题,并将不确定性与置信度建模引入该设定,以增强模型的鲁棒性与泛化能力;
• 提出证据引导的多专家框架 EvGNN,以证据不确定性量化与冲突感知决策融合抵御标签噪声,以一致性学习与伪标签学习充分挖掘无标注节点、缓解标签稀疏;
• 在 6 个常用基准与 2 个异配图基准上开展了大量实验,EvGNN 在 12 个”数据集×噪声类型”设置中的 11 个取得最优,并在校准误差与计算效率上同样表现出色。
2. 核心方法
如图1所示,EvGNN 包含四个核心模块:(1) 证据不确定性量化:基于主观逻辑为每个专家输出逐类证据与整体不确定性;(2) 冲突感知决策融合:按专家重要度加权预处理意见,再应用 Dempster 组合规则,避免高冲突场景下的反直觉融合结果;(3) 表征级深度融合:通过双瓶颈残差 MLP 建模跨专家的特征交互;(4) 一致性与伪标签学习:对齐决策级与表征级两种融合视图,并引入高置信伪标签提供辅助监督。下面依次介绍各模块的具体设计。
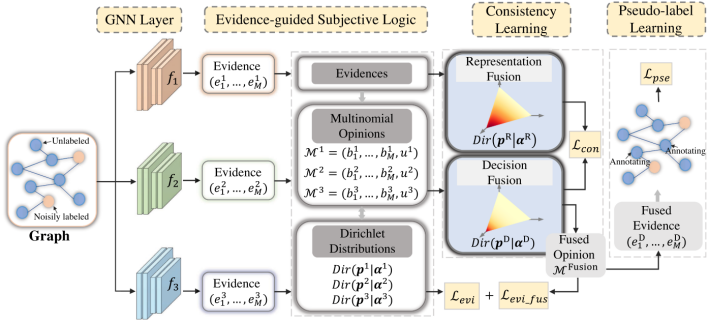
图1:EvGNN 框架图
2.1 证据不确定性量化
噪声标签之所以难以抵御,很大程度上是因为模型无法“意识到”自己的预测可能不可靠。为此,我们引入 Dempster-Shafer 证据理论指导下的主观逻辑:每个专家以 GCN 编码图结构信息,经 MLP 与非负激活输出逐类证据,并用证据参数化一个 Dirichlet 分布:证据越强,不确定性越低。由此,模型同时给出类别信念与整体不确定性,显式刻画预测的可靠程度。形式地,第 i 个专家输出的证据与信念、不确定性及 Dirichlet 参数的关系为:
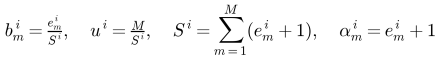
其中,S 为 Dirichlet 强度(各类证据加 1 之和),M 为类别数。
在此基础上,证据监督损失以 Dirichlet 分布为先验,在贝叶斯意义上对所有可能的类别分配取平均进行优化:
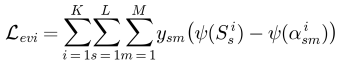
其中,y 为节点的标注标签,ψ(·) 为 digamma 函数。相比经典交叉熵,这种范式能有效缓解噪声标签的误导,且将训练与不确定性量化统一于同一框架,不引入额外计算开销。值得注意的是,仅量化不确定性并不能阻止模型记忆噪声标签,因此我们采用多专家设计:由于参数初始化与优化轨迹不同,各专家学习到互补的预测模式,对噪声的敏感度也不同,从而降低了所有专家被同一批噪声标签同时误导的风险。
2.2 冲突感知决策融合
得到多个专家的多项式意见后,经典做法是直接应用 Dempster 组合规则,即对两个专家的意见按下式融合:
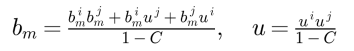
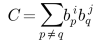
其中,C 度量两个意见之间的冲突程度。然而该规则存在反直觉缺陷:当两个专家分别以 0.99 的信念支持两个不同类别时,融合结果竟以极低的不确定性给出近乎均分的信念,其根源在于冲突质量被归一化因子整体丢弃,无法反映专家间缺乏共识的事实。
为缓解这一问题,我们在组合前先对意见进行加权预处理:用 Jensen-Shannon 散度度量专家间的分歧程度,用质量熵度量每个意见的信息量,二者共同决定各专家的重要度:
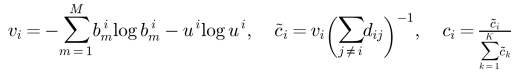
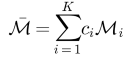
先按重要度对各意见加权平均,再执行 K-1 次 Dempster 组合,得到决策级融合意见:
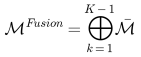
这一设计让“既保留充分信息、又获得其他专家支持”的意见主导最终决策。在理论层面,论文刻画了 Dempster 组合对正确类别信念与不确定性的影响,可表述为如下命题:
命题(融合对正确类别信念与不确定性的影响):设 t 为真实类别。当真实类别的信念不小于 1 减去 2 倍的不确定性质量,或该信念已是各类别信念中的最大值时,对加权平均意见的自组合能够保持或增强真实类别的信念;对任意两个专家意见的二元组合,在类似的充分条件下,融合后的真实类信念不低于两个输入信念中的较小者;且组合过程可持续降低不确定性质量,原不确定性质量越小,其相对降幅越大。
进一步地,论文给出了融合决策被噪声标签支配的概率上界,可表述为如下定理:
定理(噪声类别占优概率的指数上界):假设各专家不会被同一观测标签系统性误导(专家错误之间的依赖程度由因子 λ 刻画),且 λ 与加权平均误导概率的乘积小于 1/2,则融合意见中噪声类别信念不低于真实类别信念的概率满足:
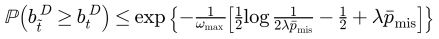
其中,ω_max 表示各专家归一化权重中的最大值,上标 D 表示决策级融合结果。该上界表明:专家间的错误越独立、权重分配越均衡,融合决策被噪声标签支配的概率越低;当各专家贡献均匀(ω_max = 1/K)时,该概率随专家数量 K 指数衰减。此外,融合意见同样施加证据监督损失,与各专家联合优化,而非仅作为事后集成。
2.3 表征级深度融合
除输出层面的决策融合外,我们还在表征层面整合多专家信息,以增强对无标注节点的利用。具体地,先将 K 个专家的节点嵌入拼接,再进行深度融合:
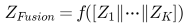
其中,f 由两个互补瓶颈结构的残差 MLP 块实现:第一个模块采用”先扩维后压缩”结构,在更大的中间空间中建模跨专家的非线性交互;第二个模块采用”先压缩后扩维”结构,鼓励保留判别信息、抑制专家特有的冗余与噪声特征。融合后的表征进一步生成类别证据,与决策层面的融合结果共同构成两个互补的学习视角。
2.4 一致性与伪标签学习
为了向无标注节点“要监督”,我们设计了两类正则。一致性学习通过最小化决策级与表征级两个融合视图对应的 Dirichlet 分布之间的 KL 散度:
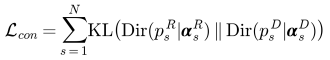
这使两种视图相互正则,无需查询任何标签即可让全图节点参与训练;伪标签学习则对决策级融合证据进行评分,选取最大分数达到 0.95 的高置信预测作为伪标签,为下一轮训练提供辅助监督。由于伪标签来自融合证据而非直接复制原始噪声标注,当伪标签与观测标签冲突时,还能进一步削弱错误标注的影响。最终,证据监督损失、一致性损失与伪标签损失按下式联合优化整个框架:
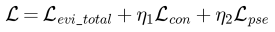
其中,η1 与 η2 为损失系数;实践中专家数取 K=3,兼顾性能与效率。
3. 实验
3.1 主实验结果
为了验证 EvGNN 的有效性,我们在 6 个常用基准(Coauthor CS、Amazon Photo、Amazon Computers、Pubmed、DBLP、Citeseer)上,以约 1%(Citeseer 为 5%)的极低标签率、20% 均匀/成对两类噪声,与 GCN、GIN、Forward、Coteaching+、D-GNN、CP、NRGNN、RTGNN、CGNN、CR-GNN、RNCGLN、MEGC、KDEM、PPEM 等 14 个基线进行了对比,所有方法重复 5 次取均值与标准差。
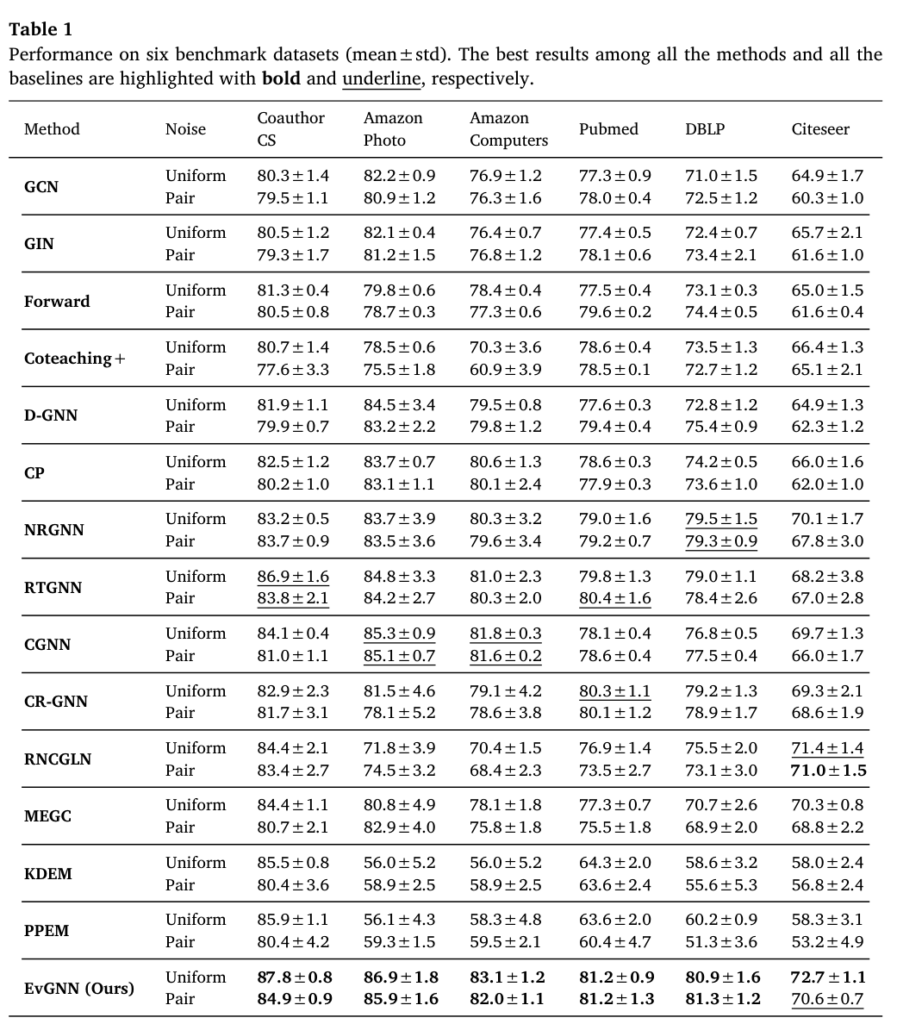
图2:六个基准数据集上的总体性能对比(均值±标准差)
实验结果表明,EvGNN 在 12 个“数据集×噪声类型”设置中的 11 个取得最优:均匀噪声下六个数据集分别达 87.8、86.9、83.1、81.2、80.9、72.7,全面超越所有基线。此外,经典 GNN 普遍劣于抗噪方法,图上专用方法普遍优于通用抗噪方法,而现有 SOTA 方法在不同数据集上各有胜负、稳定性有限,EvGNN 则展现出最稳定的整体优势。
3.2 消融实验
为验证各模块设计的合理性,我们设置了逐步叠加的对比变体:M1 仅含各专家的证据监督损失,M2 加入决策级融合,M3 再加入一致性学习,M4(完整 EvGNN)引入伪标签学习;同时比较了证据监督损失与交叉熵监督损失、证据版与交叉熵版伪标签损失,以及单专家与融合决策的差异。
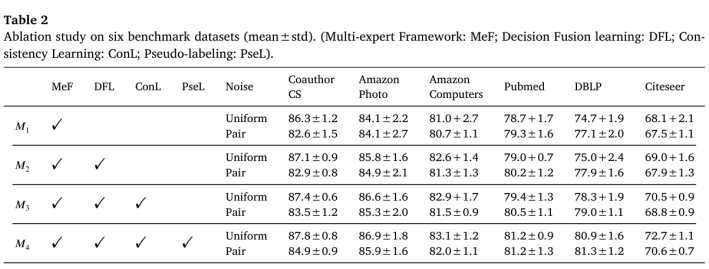
图3:核心组件消融实验
实验结果表明:逐组件加入均带来稳定增益,其中 DBLP 上一致性学习带来约 3.3 个点的跃升;证据监督损失稳定优于交叉熵监督损失,而交叉熵版伪标签优于证据版伪标签,二者形成互补:前者通过不确定性建模抵御噪声观测标签,后者借助可靠伪标签提供额外监督;融合决策在所评估的全部设置下均优于任何单一专家,验证了专家多样性与融合机制的有效性。
3.3 鲁棒性与异配图分析
为进一步考察 EvGNN 在极端监督条件下的表现,我们将噪声率在 10% 至 40% 之间变化、并在不同标签率下与四个最强基线(NRGNN、RTGNN、CGNN、CR-GNN)对比;同时在 Roman-Empire 与 Amazon-Ratings 两个异配图基准上评估(配合解耦的 GCN 编码器,减少相异邻居间的有害特征混合)。
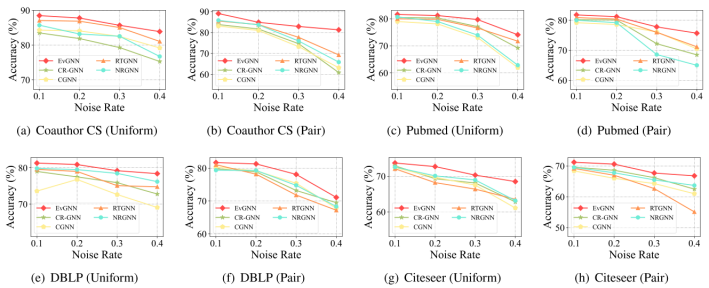
图4:不同噪声率下的性能对比
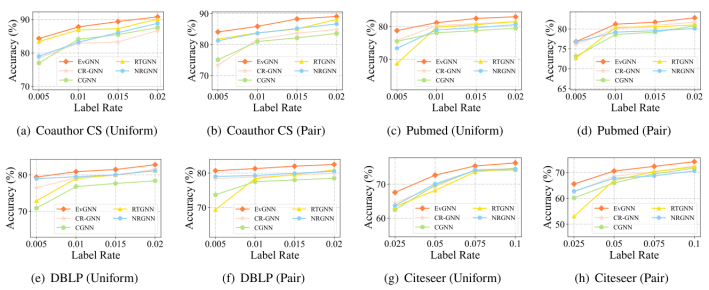
图5:不同标签率下的性能对比
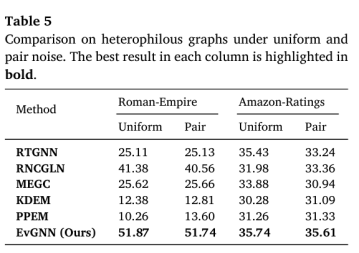
图6:异配图(Roman-Empire / Amazon-Ratings)上的性能对比
实验结果表明:EvGNN 在全部噪声率与标签率下一致领先,且噪声越大、标签越稀缺,领先优势越明显;在两个异配图基准的四种设置下全部最优,其中 Roman-Empire 上取得 51.87,远超最优基线 RNCGLN 的 41.38。
3.4 校准与计算效率分析
不确定性建模的价值最终体现在预测的可靠性上。我们在 Pubmed 与 DBLP 上对比了 EvGNN 与普通 GCN 的可靠性图与期望校准误差(ECE),并通过向测试节点加入高斯噪声构造分布外(OOD)数据,考察不确定性估计的区分能力;同时统计了各方法在 8 个数据集上的每 epoch 训练时间与峰值显存。
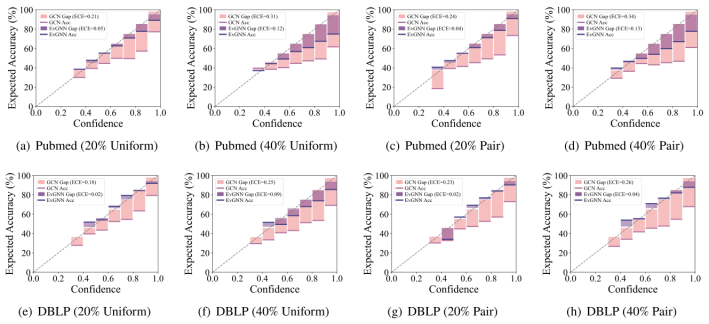
图7:EvGNN 与 GCN 的校准差距及 ECE 对比
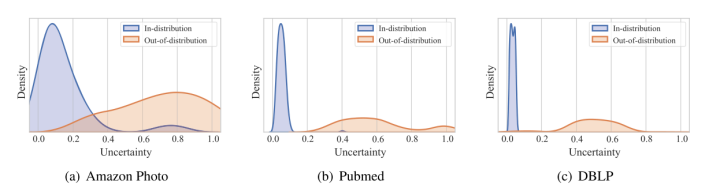
图8:分布内/分布外数据的不确定性分布
实验结果表明:EvGNN 显著缩小了置信度与经验准确率之间的差距,各设置下 ECE 均低于 GCN;不确定性估计可有效区分分布内外数据:以 Amazon Photo 为例,分布外节点的平均不确定性超过 0.6,而分布内仅约 0.15。效率方面,EvGNN 在 8 个数据集中的 7 个取得最短每 epoch 训练时间,显存占用适中,在保持最优性能的同时具备实用的计算开销。
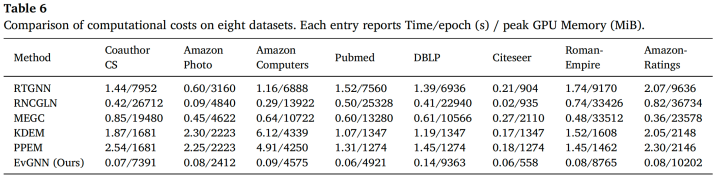
图9:不同方法的计算效率对比(每 epoch 训练时间 / 峰值显存)
4. 结论
本文提出 EvGNN,一个证据引导的多专家图学习框架,将图神经网络的训练从“默认标签可靠”的理想设定,扩展到噪声且稀疏的真实监督场景。通过主观逻辑量化预测不确定性、以冲突感知策略融合多专家意见、并借助一致性学习与伪标签充分挖掘无标注节点,EvGNN 在多个基准上实现了性能、校准与效率的统一。EvGNN 仍存在一些局限:专家数量依赖经验设定、缺乏自适应选择机制;专家表征间的交互建模仍有提升空间;高置信度伪标签仍可能出错。未来,我们将探索自适应的多专家设计与更具表达能力的融合机制、更可靠的伪标签策略,并将框架扩展到错误检测、分布外检测与多源不确定性等安全关键场景。
作者简介:
易思宇,四川大学数学学院特聘副研究员,入选国家博新计划(国资计划A档)。研究方向为图机器学习、大数据子抽样、及生物信息学等。主持国家自然科学基金青年基金、中国博士后科学基金面上项目、四川省自然科学基金青年基金。迄今已以第一作者/通讯作者在包括IEEE TPAMI、IEEE TMM、IEEE TNNLS、JCGS、AIJ、ICML、ICLR、WWW在内的人工智能和统计学领域高水平期刊和会议上发表SCI论文20余篇。在ICLR、ICML、NeurIPS、ACL、TNNLS、PR等多个国际顶级会议和期刊担任领域主席和审稿人。
琚玮,四川大学人工智能学院特聘副研究员,入选国家博新计划(国资计划A档),天府峨眉计划青年人才(四川省“千人计划”),2025-2026年度斯坦福大学年度全球前2%顶尖科学家,中国计算机学会人工智能与模式识别专委会委员,中国中文信息学会大模型与生成专业委员会委员。研究方向为图机器学习、生物信息学、大语言模型、推荐系统。主持国家自然科学基金(面上+青年)、国家科技重大专项子课题、四川省自然科学基金青年基金B类、中国博士后科学基金面上项目等多项国家级和省部级课题。目前已在国际顶级学术期刊和会议上发表论文100余篇(Nature子刊1篇,CCF-A/一区论文80余篇),研究成果发表在Nature Machine Intelligence、TPAMI、TKDE、TOIS、TMM、AIJ、ICLR、ICML、NeurIPS、CVPR、ACL、KDD、WWW、AAAI等国际顶级期刊和会议上,累积被引5000余次,其中多篇会议论文入选最佳论文/口头报告(ICLR 2026 Oral Paper, Top 1%、ICDM 2022最佳论文提名奖、ISNN 2026最佳学生论文奖),并荣获2023年度ACM SIGCSE中国“优博奖”。受邀担任国际顶级期刊TCSVT、Pattern Recognition、Expert Systems with Applications副主编,Information Fusion、Neurocomputing、Applied Soft Computing、Frontiers in Big Data编委, ICLR、ICML、ACL、KDD、AAAI、ACMMM 等国际顶级会议领域主席。